Memoria para agentes de IA: capas, dreaming y evaluaciones que no engañan

En esta página
Un agente de IA que habla con el mismo cliente todos los días debería mejorar con el tiempo. En la práctica, cada sesión empieza de cero, y la salida más habitual es meterlo todo en el contexto, algo que funciona unas semanas y luego empeora.
En este post explicamos la memoria por capas que Anthropic describió el 6 de noviembre de 2026, el proceso que llama dreaming ("soñar") y lo que muestran las pruebas. Después, a partir de un texto de Anthropic del 13 de noviembre, te contamos cómo evaluar un cambio así sin engañarte.
#Por qué meterlo todo en el contexto no escala
Para Anthropic, la memoria de un agente es el conocimiento que el modelo gana con la experiencia y conserva de una sesión a otra. Cargarlo todo en cada sesión parece seguro, pero tiene tres problemas:
- Coste. Todo lo que entra en el contexto se paga en tokens y compite por espacio con la tarea.
- Adherencia. Según el texto, los archivos de instrucciones más largos se siguen con menos fidelidad.
- Errores repetidos. Una nota equivocada que entra en cada sesión las contamina todas.
En una prueba con Pokémon Rojo, Sonnet 3.7 escribió 413 archivos de memoria en 225 carpetas y consiguió una medalla. Fable 5, con nueve archivos en dos carpetas y un archivo general, consiguió cuatro. Más no es mejor.
#Memoria en cuatro capas
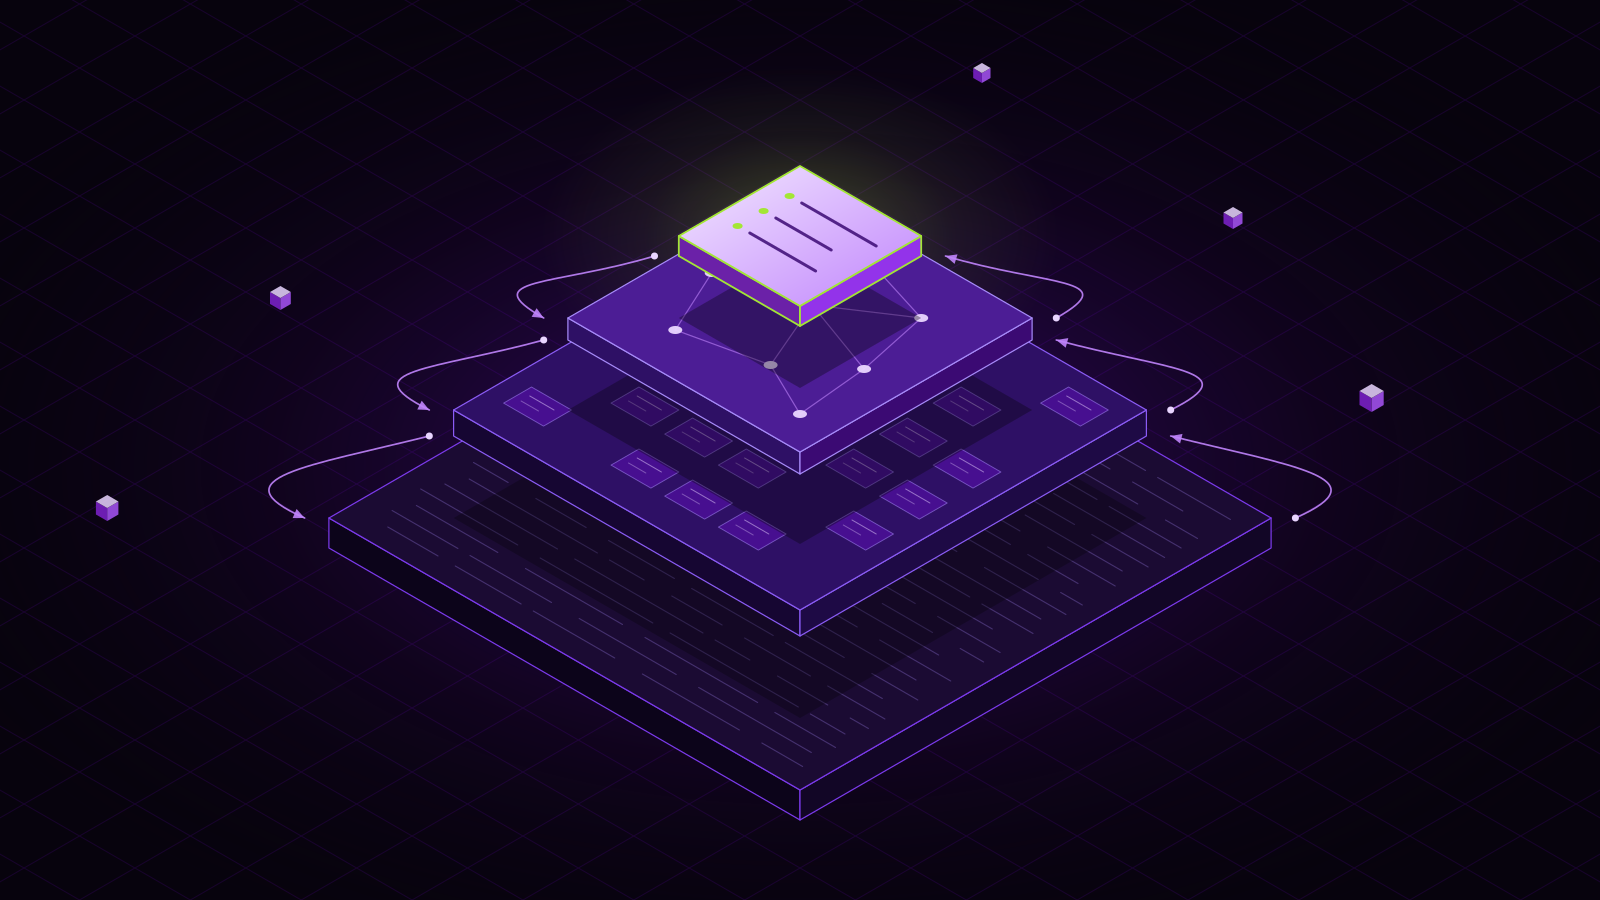
La propuesta es una pila, de la capa más en bruto a la más destilada:
- Transcripciones. El registro completo de las sesiones, que se consulta mediante búsqueda.
- Notas. Observaciones que escribe el propio modelo, como una preferencia del cliente.
- Representaciones. Estructuras creadas a partir de notas y registros, como una wiki con páginas enlazadas entre sí.
- Contexto siempre cargado. Lo poco que entra en cada sesión, y que tiene que seguir siendo pequeño.
Claude Code sigue esta lógica: al inicio de cada conversación, la memoria automática carga solo las primeras 200 líneas o los primeros 25 KB de MEMORY.md, lo que llegue antes. El archivo sirve de índice, y los detalles quedan en archivos por tema que se abren cuando hace falta.
Un ejemplo genérico, para un agente de atención al cliente:
memoria/
├── INDICE.md               # siempre cargado: corto, una línea por tema
├── notas/
│   ├── preferencias.md     # "prefiere respuestas cortas, sin jerga"
│   └── correcciones.md     # errores ya cometidos y cómo se corrigieron
├── wiki/
│   ├── productos.md
│   └── procesos.md         # páginas enlazadas entre sí
└── transcripciones/        # historial completo, solo para búsqueda
    └── 2026-11-14.jsonl
La regla práctica: en el índice entra solo lo que el agente usa en casi todas las conversaciones, más la ruta hacia lo demás.
#Qué es el dreaming
Anthropic se inspira en el cerebro: el hipocampo registra experiencias con rapidez y, durante el descanso, las repasa para consolidarlas en el neocórtex. En un agente, el dreaming es esa consolidación: el modelo reflexiona sobre sus registros para corregir errores y producir notas y representaciones nuevas. Contrasta notas con la transcripción, amplía una wiki, sube una nota a la cima o baja detalles y deja solo un enlace.
Llevar este trabajo a segundo plano evita que tomar notas sobre la marcha distraiga al modelo. La contrapartida es que el resultado puede no estar disponible al momento.
En Pokémon, el modelo anotó por error que el Centro Pokémon estaba en el lado este y, siguiendo esa nota, volvió a un tramo anterior del juego. Durante el dreaming, comparó la nota con la transcripción y corrigió el error. Con la nota corregida, llegó a Ciudad Celeste. Con la nota equivocada, o sin memoria, no llegó.
#Qué muestran las cifras
Las cifras son de pruebas de la propia Anthropic:
- CL-Bench. En una prueba de aprendizaje continuo (Continual Learning Bench) basada en consultas a una base de datos, Opus 5.5 pasó de una recompensa media de 0,655 sin memoria a 0,838 con memoria.
- Las reglas rígidas estorban. Con la regla "registra solo los fallos", Opus 5 y Opus 4.7 perdieron buena parte de la ganancia. En los modelos más capaces, dejar que el modelo decida qué guardar funcionó mejor: dile para qué sirve la memoria, no cómo usarla.
- Una gran base de documentos. En una base de unos 350.000 archivos (unos 420 millones de tokens), agentes Opus 5 dedicaron 128 sesiones a construir una wiki con dreaming. Usando solo la wiki, el acierto en 25 preguntas subió del 13 % al 48 % de los criterios evaluados. Con wiki y búsqueda llegó al 61 %, frente al 53 % solo con búsqueda, y ahorró unos 20.000 tokens por pregunta.
Hay límites: el dreaming consume cómputo, las wikis necesitan mantenimiento y no siempre ayudan, y la búsqueda en las transcripciones puede ser la base de todo.
#Cómo evaluar un cambio así sin engañarte
La prueba de la base de documentos usó 25 preguntas: es una buena señal, no una garantía para tu agente. Para saberlo, hay que medir.
El texto del 13 de noviembre trata de evaluaciones (evals, pruebas que miden el comportamiento de un modelo) de seguridad. En nuestra lectura, varios de sus consejos valen para cualquier cambio en un agente:
- Decide el análisis de antemano. Es el prerregistro: anotar la métrica principal, las comparaciones, los cortes de datos y el umbral que cuenta como mejora o empeoramiento antes de ver los resultados.
- Usa una muestra suficiente. Anthropic considera 100 elementos el mínimo para una evaluación compleja, de varios turnos, y 1.000 para una sencilla, de un solo turno. Ejecuta cada caso varias veces y muestra la dispersión.
- Compara por pares. Ejecuta las dos versiones con los mismos elementos y calcula el intervalo de confianza de la diferencia elemento a elemento.
- Calibra al evaluador. Si un modelo pone las notas, unos expertos etiquetan una muestra sin ver su veredicto. La concordancia debe descontar el azar, con estadísticos como el kappa de Cohen, y acercarse a la que tienen los expertos entre sí.
- Muestra la incertidumbre en cada número. En evaluaciones de varios turnos, el intervalo de confianza puede superar los 10 puntos porcentuales hacia cada lado. En el texto, un 98 % frente a un 94 % entre dos modelos no fue una diferencia estadísticamente significativa.
- Cambia una sola cosa cada vez. En Fable 5.1, la tasa de respuestas adecuadas varió hasta 34 puntos porcentuales entre la API y claude.ai, porque claude.ai aplica un prompt de sistema.
Para la memoria, la receta es esta: un conjunto fijo de tareas parecidas a las reales, métrica y ganancia mínima decididas de antemano, versiones con y sin memoria ejecutadas sobre los mismos elementos con todo lo demás igual, y una ganancia aceptada solo si el intervalo de confianza de la diferencia queda entero por encima de cero.
#Qué cambia para quien construye agentes
En MEYJE construimos agentes de IA para clientes, como el asistente financiero de RuralZap en WhatsApp. Tres lecciones ya forman parte de nuestra forma de diseñarlos:
- Memoria pequeña y cuidada. Lo que entra en cada conversación cabe en un índice corto. El resto vive en notas y páginas, y el historial completo, en la búsqueda.
- Di para qué sirve, no cómo hacerlo. Explica el objetivo, deja que el modelo decida qué guardar y reserva una revisión periódica, fuera de la conversación, para corregir y reorganizar.
- Medir antes de creer. Sin una métrica decidida de antemano, una muestra suficiente, un evaluador calibrado e intervalos de confianza, una ganancia vistosa puede ser solo ruido.
Una buena memoria no es la que más guarda, sino la que ayuda al agente a equivocarse menos mañana. Si quieres poner un agente de IA a trabajar con los sistemas de tu empresa, habla con nosotros.